
一个人做 AI 定制单的完整工作流 (附 3 条反常识)
大家好,我是白露。本职在集团里管内部的软件部门,今年业余开始试着用 AI 半自动地接企业和个人的定制需求。攒了点心得,简单分享一下,大佬们见笑。
先说个场景,接过单的圈友应该都熟。上午在 A 项目里调视频,正调得起劲,手机一震,甲方 B 的群 99+。点进去:
这时候脑子得飞快地把 B 项目整个重新装一遍:之前定了啥,否掉过啥,现在到底要我干嘛。人脑其实跟大模型一样,每次切上下文都要缓一会儿。一天切三四个项目,头皮发麻。
国内接单,需求基本都在微信里。飞书文档只占一部分,大量的改动是群里随口一句、一条 60 秒语音、几张截图。人去翻聊天记录,慢,还容易漏。漏看一条,就可能返工一轮。
所以我做的第一件事,就是让 AI 能读微信。这类工具有好几个,我用的是 wechat-cli。
甲方特别爱发语音,没关系,它会先转成文字再查。截图它也能自己导出来看。
之前做的一个系列课程剪辑,前面几集,每集甲方都改了 20 多轮。改到第 8 轮,第 3 轮说过什么,我不记得,甲方自己也不记得。
后来我想明白了:靠自己一遍遍对齐上下文、记住中间改过的每个需求,又累又容易错。干脆让 AI 全程参与对齐需求,把每个需求怎么来的、后来怎么变的,全都记下来。
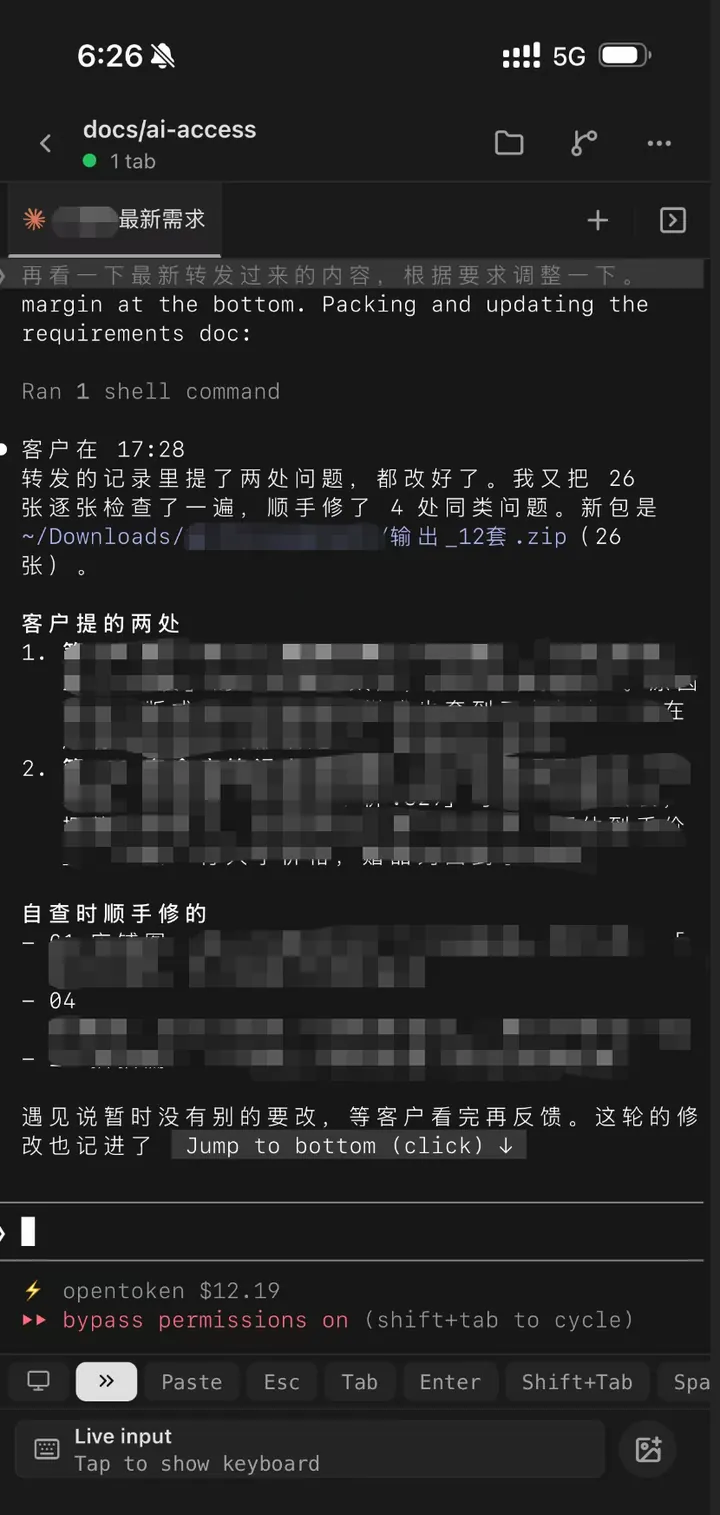

我所有项目都扔在一个叫 Dev-Local 的文件夹里,现在攒了 100 多个。每个项目我都写了 README.md 和 CLAUDE.md(或者 AGENTS.md),说清楚它是干嘛的、怎么用。
一个项目要用到另一个项目的时候,我直接把那个项目的路径告诉 AI,它自己就会去读说明。常用的几个,我干脆写成一页清单。
有了这些上下文,甲方在群里丢个抖音链接,AI 自己就去调自媒体系统抓了,不会回你一句「我无法访问该链接」。
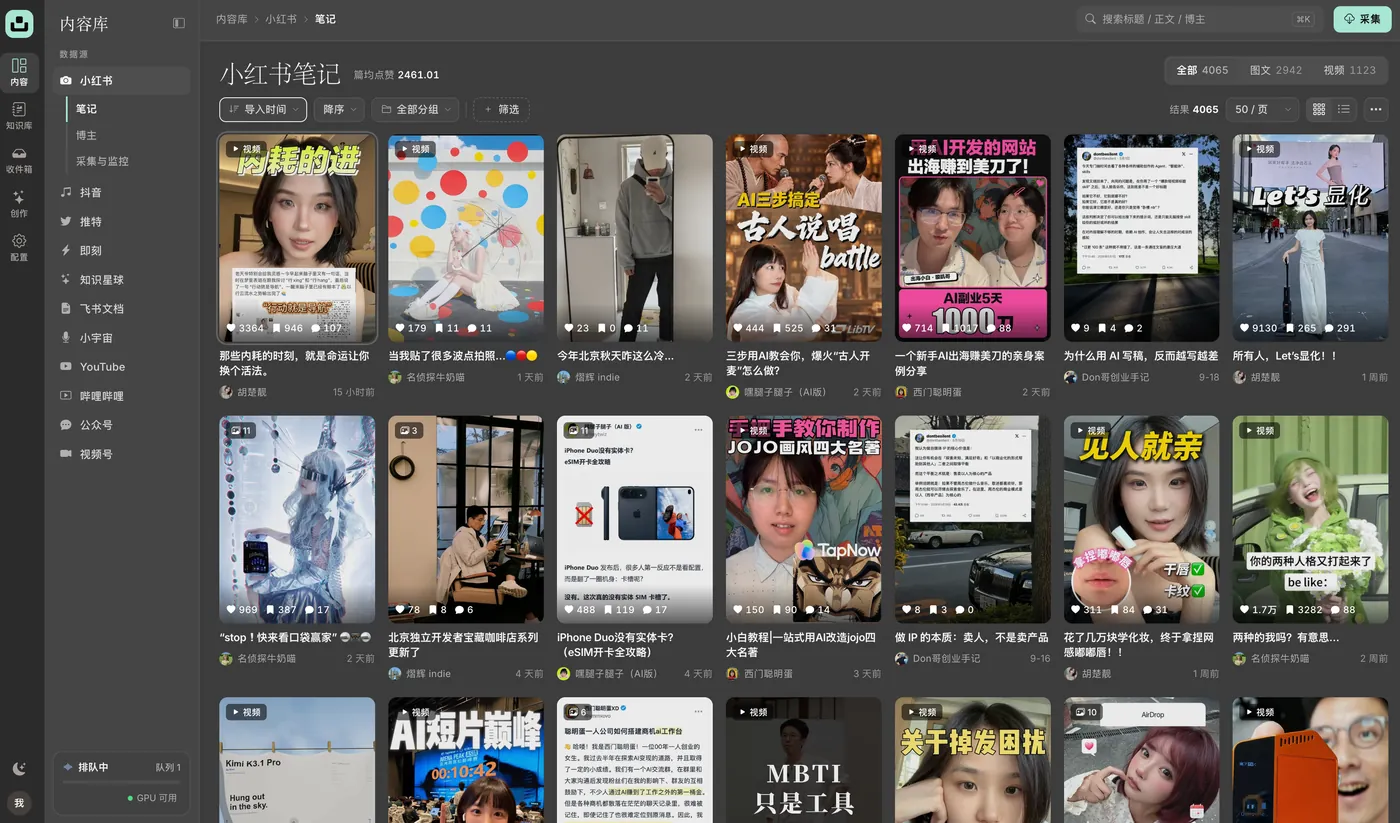
这些能复用的项目,大部分是给别人做完定制单之后,消化成了自己的东西。

有条件的话,至少买一台云服务器、一个域名。国内的轻量服务器和域名,现在都很便宜。
我服务器上装了 Dokploy,一个开源的部署面板,应用、数据库、域名、HTTPS 证书都在上面管。服务器上跑着什么、哪个项目什么状态,面板上一眼就能看到。
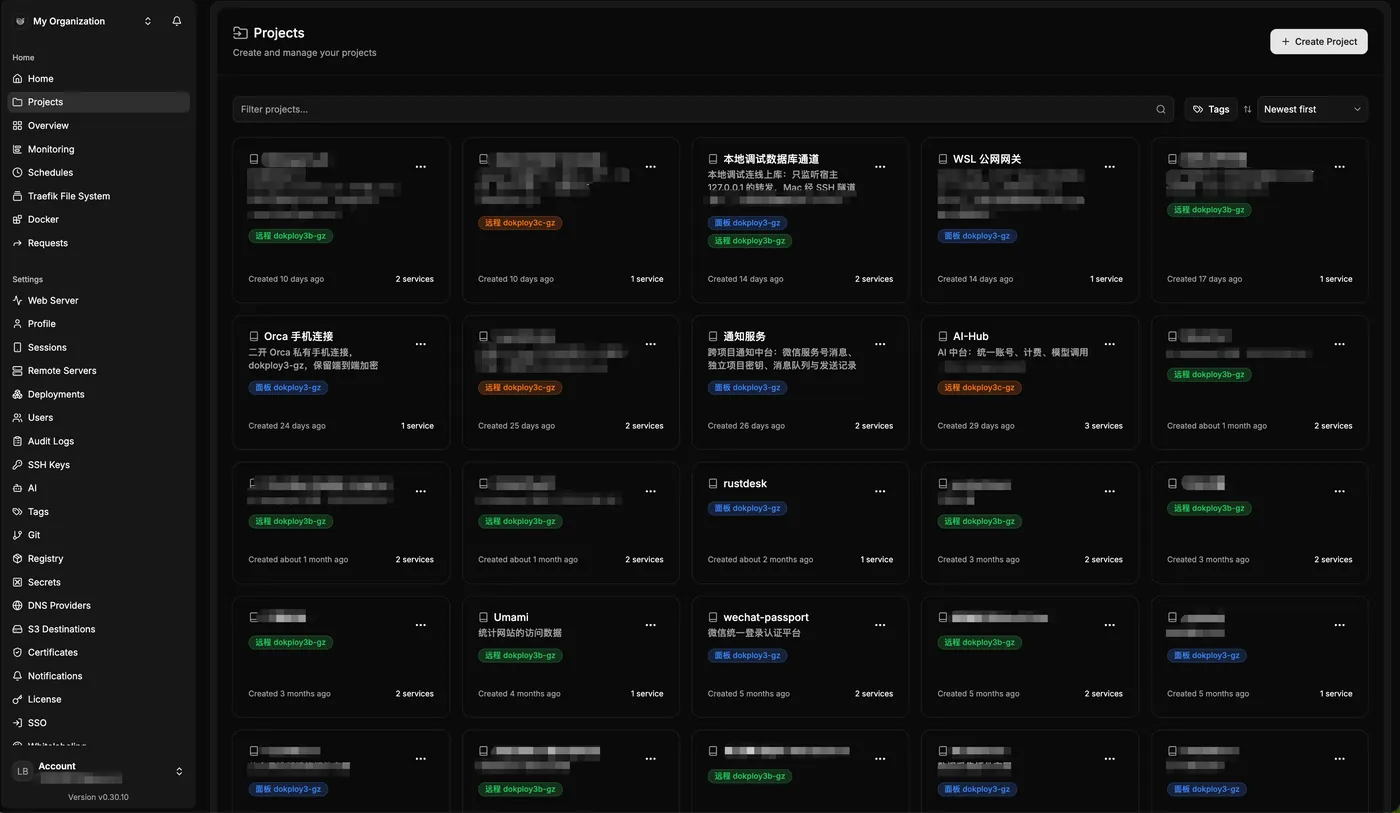
分工很简单:我看面板,AI 走接口。腾讯云有命令行工具 tccli,阿里云有 aliyun cli,Cloudflare 有 API Token,Dokploy 也能生成 API Key。这些钥匙给到 AI,加解析、建应用、部署、看日志,都让 AI 搞定。
服务器还有个好处:它有公网 IP。借它中转一下,自己电脑上的东西,在外面也能用。以前大家多用 Tailscale 这类组网工具,好用是好用,但:
| Tailscale 这类组网工具 | 自己的服务器中转 | |
|---|---|---|
| 每台设备 | 都得装客户端、登同一个账号 | 手机上什么都不用装 |
| 给甲方看 | 总不能让人家也装一个 | 发个链接就行 |
| iPhone 上 | 占着 VPN 的位置,开了它代理就得关 | 不占 |
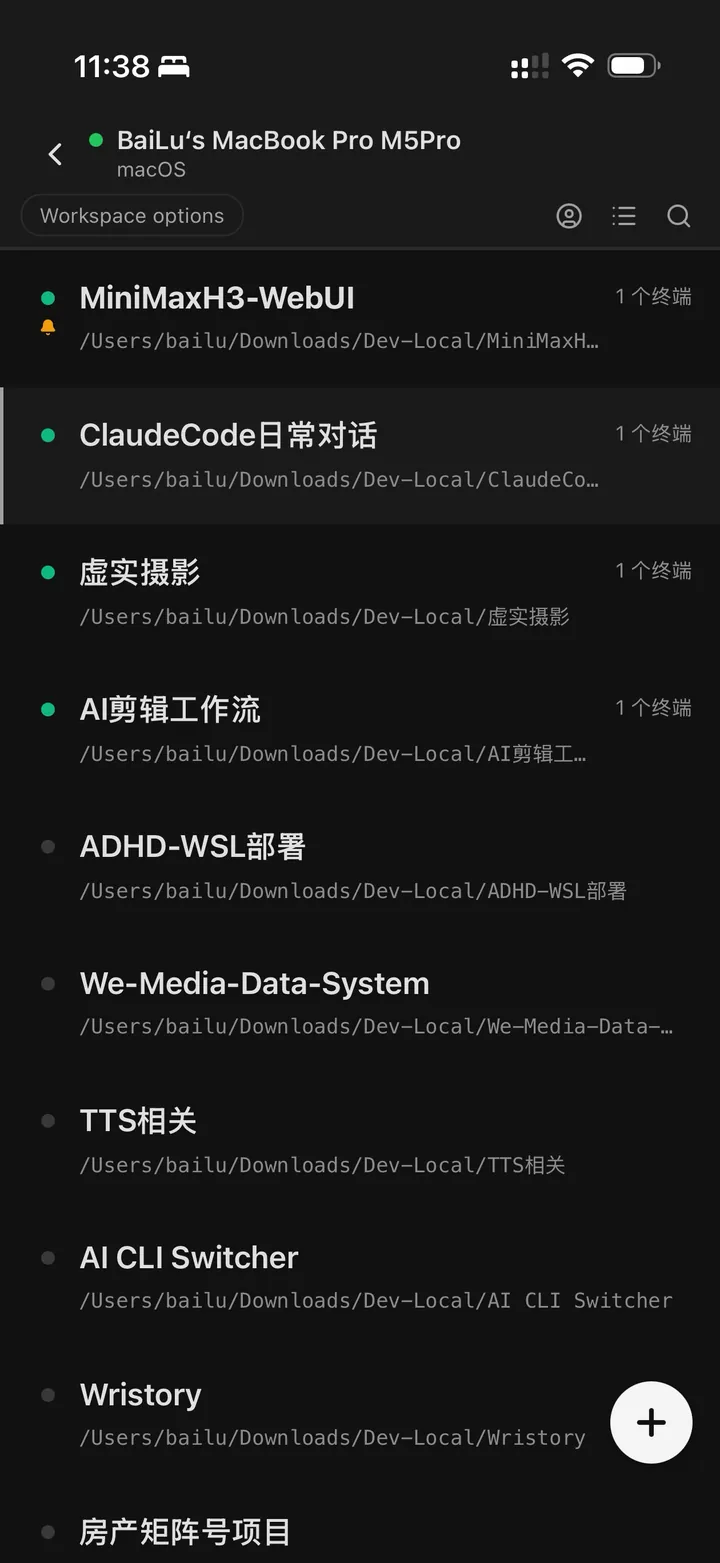
我在用 Orca,一个开源的 AI 编程调度工具,能同时开好几个 Claude Code、Codex 会话,还带手机 App。官方的手机连接走的是官方中转,我自己二次开发了一下,改成自己用着顺手的样式,去掉了 Agent 的过度设计;再把官方中转、遥测这些对外连接全关了,在自己服务器上搭了个小中转,手机走我自己的域名连回电脑。
工具和做法讲完了,再聊几条我自己的看法,可能跟现在流行的说法不太一样。点开每一条看。
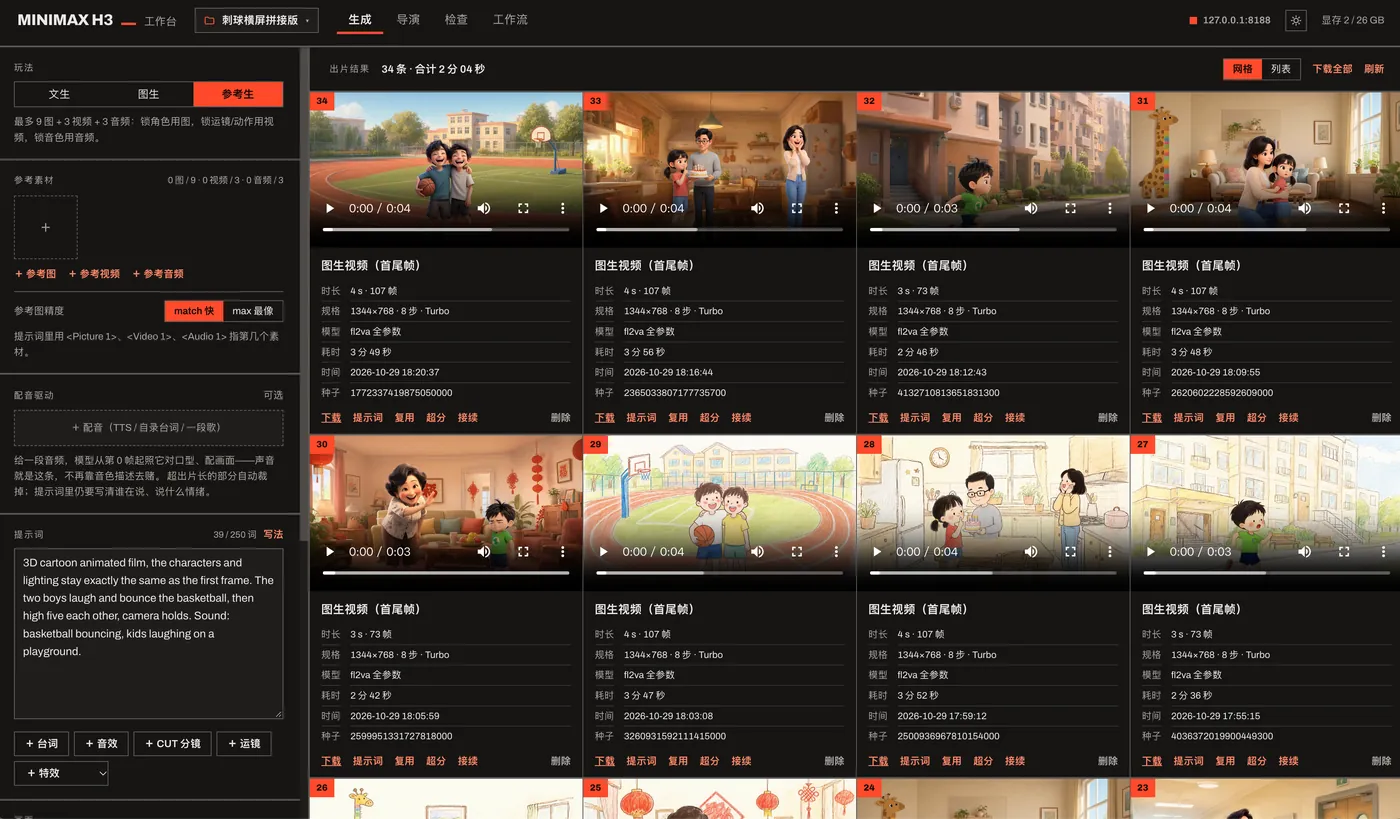
先说清楚,这里说的工作台是狭义的:那种做得挺好看的 WebUI,上面一堆按钮能点、一堆结果能看。前面列的几个都是这种,对外说起来也唬人:「这是我的 XXX 工作台。」拿它做宣传、给甲方演示、卖定制单,挺好用的,甲方看到一个漂亮界面,就觉得你有一套东西。
但你自己心里得有数:在网页上一条条填提示词、点生成、干等、再一张张下载,效率很低。采数据也一样,一个个粘链接、点抓取,这不应该由人来做。
真正帮我提效的,是 Agent:Claude Code、Codex、WorkBuddy 这种能直接跟 AI 对话、让它自己动手的。我的做法是把每个项目的接口和原理写成文档或者 skill,在这个项目目录里打开 Agent,整个项目就是它的上下文,然后说一句:
它调接口批量提交,我去干别的。跑完了,我再打开 WebUI 的画廊挑。
我觉得大部分时候,这么搞除了让 token 多烧一点,没啥意义。还挺容易上头,觉得自己手下管着一个团队,实际产出了个寂寞。
现在的模型已经很成熟了,用不着「你是一名资深 XX 工程师」这种话来激活。它干得好不好,看你给的上下文:项目是什么、甲方要啥、以前踩过什么坑。角色整一堆,上下文稀碎,每个角色只知道一块,传来传去,原意都变了。
一张消费级显卡能跑的,是量化过的中小模型,比如常见的 Qwen 3.8 27B,跟线上的大模型比还是差得远。接单要干的活,读需求、写脚本、写代码,偏偏最吃模型能力。线上的比如 DeepSeek 已经很便宜了,比本地跑划算多了。而且本地模型一跑起来就把显存吃满,这张卡就干不了别的了。
本地显卡划算的地方,我自己用得最多的:
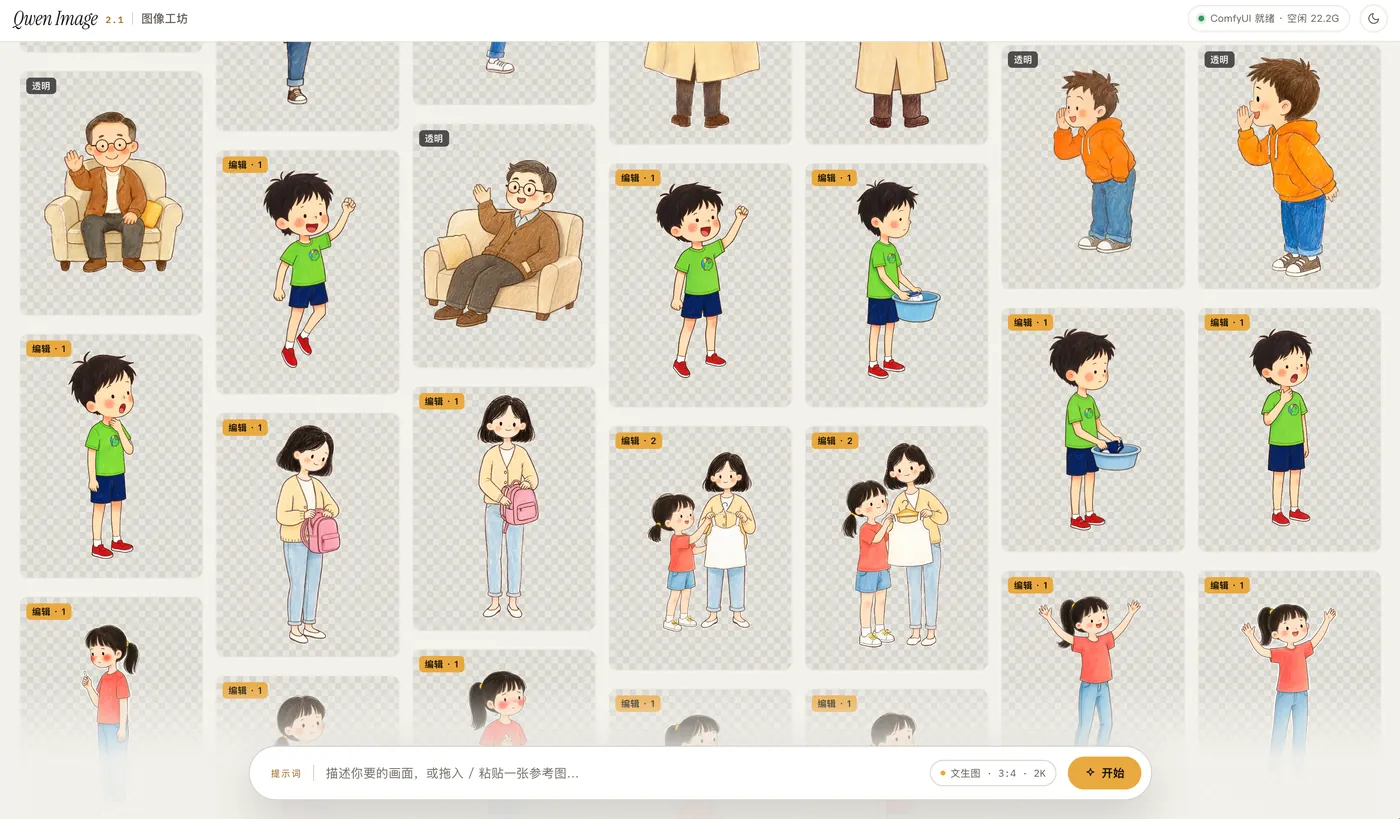
前面这几样东西,在一个案例里是怎么串起来的?拿给 IP 做获客短视频举个例子。
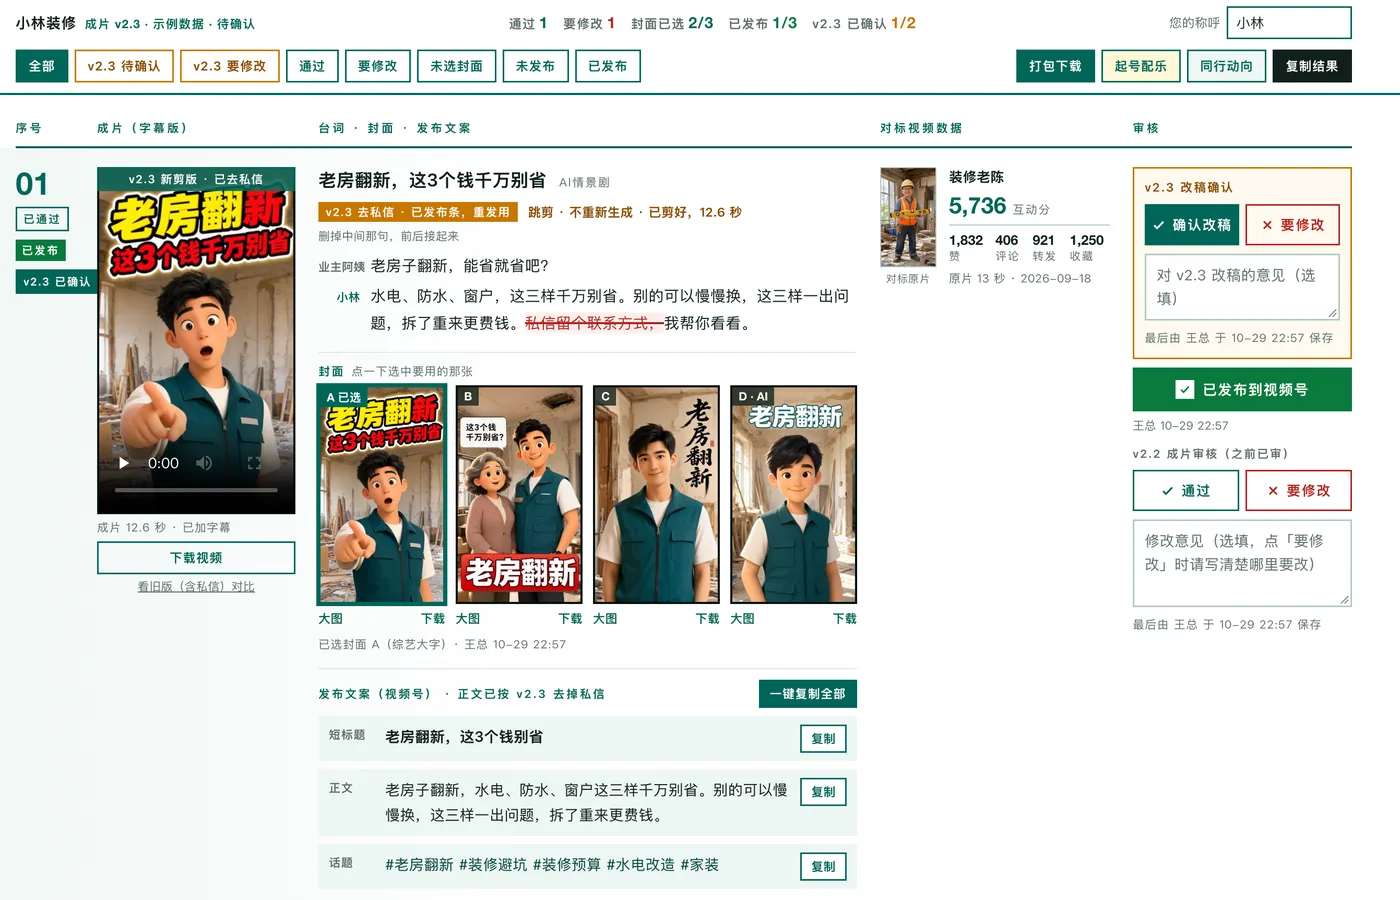
抓数据、做分析、出片、部署,都在后台自动跑,我只在开头说清楚要什么,最后检查一遍。最终效果,甲方挺满意。
网页上什么都能点、能选,呈现方式也灵活,可以按甲方关注的重点来调。视频放一页,每条下面有几张可选的封面、口播台词、标题、正文、tag,点一下就能复制。甲方要做的只剩挑和发。
点击打勾,进度记在这台设备上。
照着搭的时候可以直接去这些仓库看。